

Cuando un generador de imágenes crea un retrato, una ilustración o una escena fantástica, una de las preguntas más discutidas es de dónde salió realmente esa imagen. ¿Puede vincularse con una obra concreta del conjunto de entrenamiento? ¿Se parece a un artista específico porque lo copió o porque aprendió patrones más generales? Un estudio de MIT sugiere que, en muchos casos, esa búsqueda puede no tener una respuesta clara.
El trabajo, publicado en Nature Communications, analizó modelos de difusión, la familia de sistemas que hoy domina la generación automática de imágenes. Los investigadores encontraron que, a medida que estos modelos se entrenan con conjuntos de datos más grandes, el peso de cada ejemplo individual se diluye hasta hacerse muy difícil de detectar. El equipo llamó a este fenómeno “decadencia de atribución”.
La idea central es simple, aunque probarla no lo sea. Si se quita una imagen del entrenamiento y la salida del modelo no cambia, entonces esa imagen no parece haber influido de forma decisiva en el resultado. Según los autores, eso también vale si se elimina toda la obra de un artista o todas las fotos de una persona y la imagen generada sigue siendo prácticamente la misma.
Para poner a prueba esa idea, el equipo diseñó una arquitectura llamada “diffusion ensemble”. En lugar de entrenar un único modelo grande, dividieron el aprendizaje en múltiples componentes más pequeños, cada uno expuesto a una parte distinta de los datos. Eso les permitió apagar selectivamente las partes que habían visto cierto material y observar qué cambiaba sin tener que reentrenar el sistema desde cero cada vez.
Los investigadores compararon 24 de estos conjuntos con modelos de difusión convencionales entrenados sobre los mismos datos. Después probaron qué pasaba cuando eliminaban ejemplos del entrenamiento en colecciones que iban desde 256 imágenes hasta más de 160.000. El patrón fue consistente: cuanto mayor era la base de datos, menor era el efecto detectable de quitar una imagen concreta. En otras palabras, la salida parecía depender cada vez menos de una fuente individual y más de una mezcla estadística mucho más distribuida.
Eso no significa que los modelos sean mágicamente independientes de sus datos. Siguen aprendiendo de ellos y sin ese material no existirían. Lo que cambia, según el estudio, es la posibilidad de señalar una imagen específica y decir: “esta salida viene de aquí”. Para los autores, en modelos grandes ese vínculo puede disolverse hasta volverse inapreciable.
El resultado importa porque toca un debate que ya salió de los laboratorios. Empresas tecnológicas, artistas, jueces y legisladores discuten si las imágenes generadas por IA deben tratarse como obras derivadas de material protegido por derechos de autor. Este estudio no resuelve por sí solo esa discusión, pero sí complica la idea de que siempre pueda encontrarse una línea directa entre una salida y una obra individual del entrenamiento.
También hay una consecuencia científica y técnica. Si el hallazgo se sostiene en otros contextos, puede cambiar cómo se investiga la influencia de los datos en sistemas generativos y cómo se diseñan herramientas para auditar modelos. El artículo plantea, además, que entender esta pérdida de rastro podría ayudar a construir sistemas en los que sea más claro cuándo una semejanza se debe a copia y cuándo surge de combinaciones más generales aprendidas por el modelo.
El estudio, sin embargo, tiene límites importantes. Se centró en generadores de imágenes basados en difusión, no en modelos de lenguaje como los que están en el centro de muchos conflictos actuales sobre texto e IA. Además, la “decadencia de atribución” no implica que desaparezcan todos los problemas de propiedad intelectual, sesgo o uso indebido de datos. Solo muestra que, en ciertos modelos y a determinada escala, rastrear una salida hasta un ejemplo concreto puede dejar de ser una estrategia útil.
Esa distinción es importante. La investigación no dice que entrenar con obras ajenas sea irrelevante ni que la discusión legal esté cerrada. Lo que muestra es algo más incómodo: puede llegar un punto en que el modelo siga dependiendo del conjunto completo de datos, pero ya no de una pieza individual de manera demostrable. Para un debate público que suele buscar responsables claros y cadenas de influencia precisas, ese resultado vuelve el problema mucho más difícil de encajar.
When AI art has no author: Study finds generated images often can’t be traced to training data · MIT News Research
Ciencias.uy / MiniMax image-01 · Imagen generada con MiniMax image-01 para Ciencias.uy; uso editorial no comercial; CC BY 4.0 · Fuente de imagen
Dai, Z., & Gifford, D. K. (2026). Outputs of generative diffusion models are often unattributable. Nature Communications, 17, 6974. https://doi.org/10.1038/s41467-026-75667-5
Relacionadas por categoría
Ver mas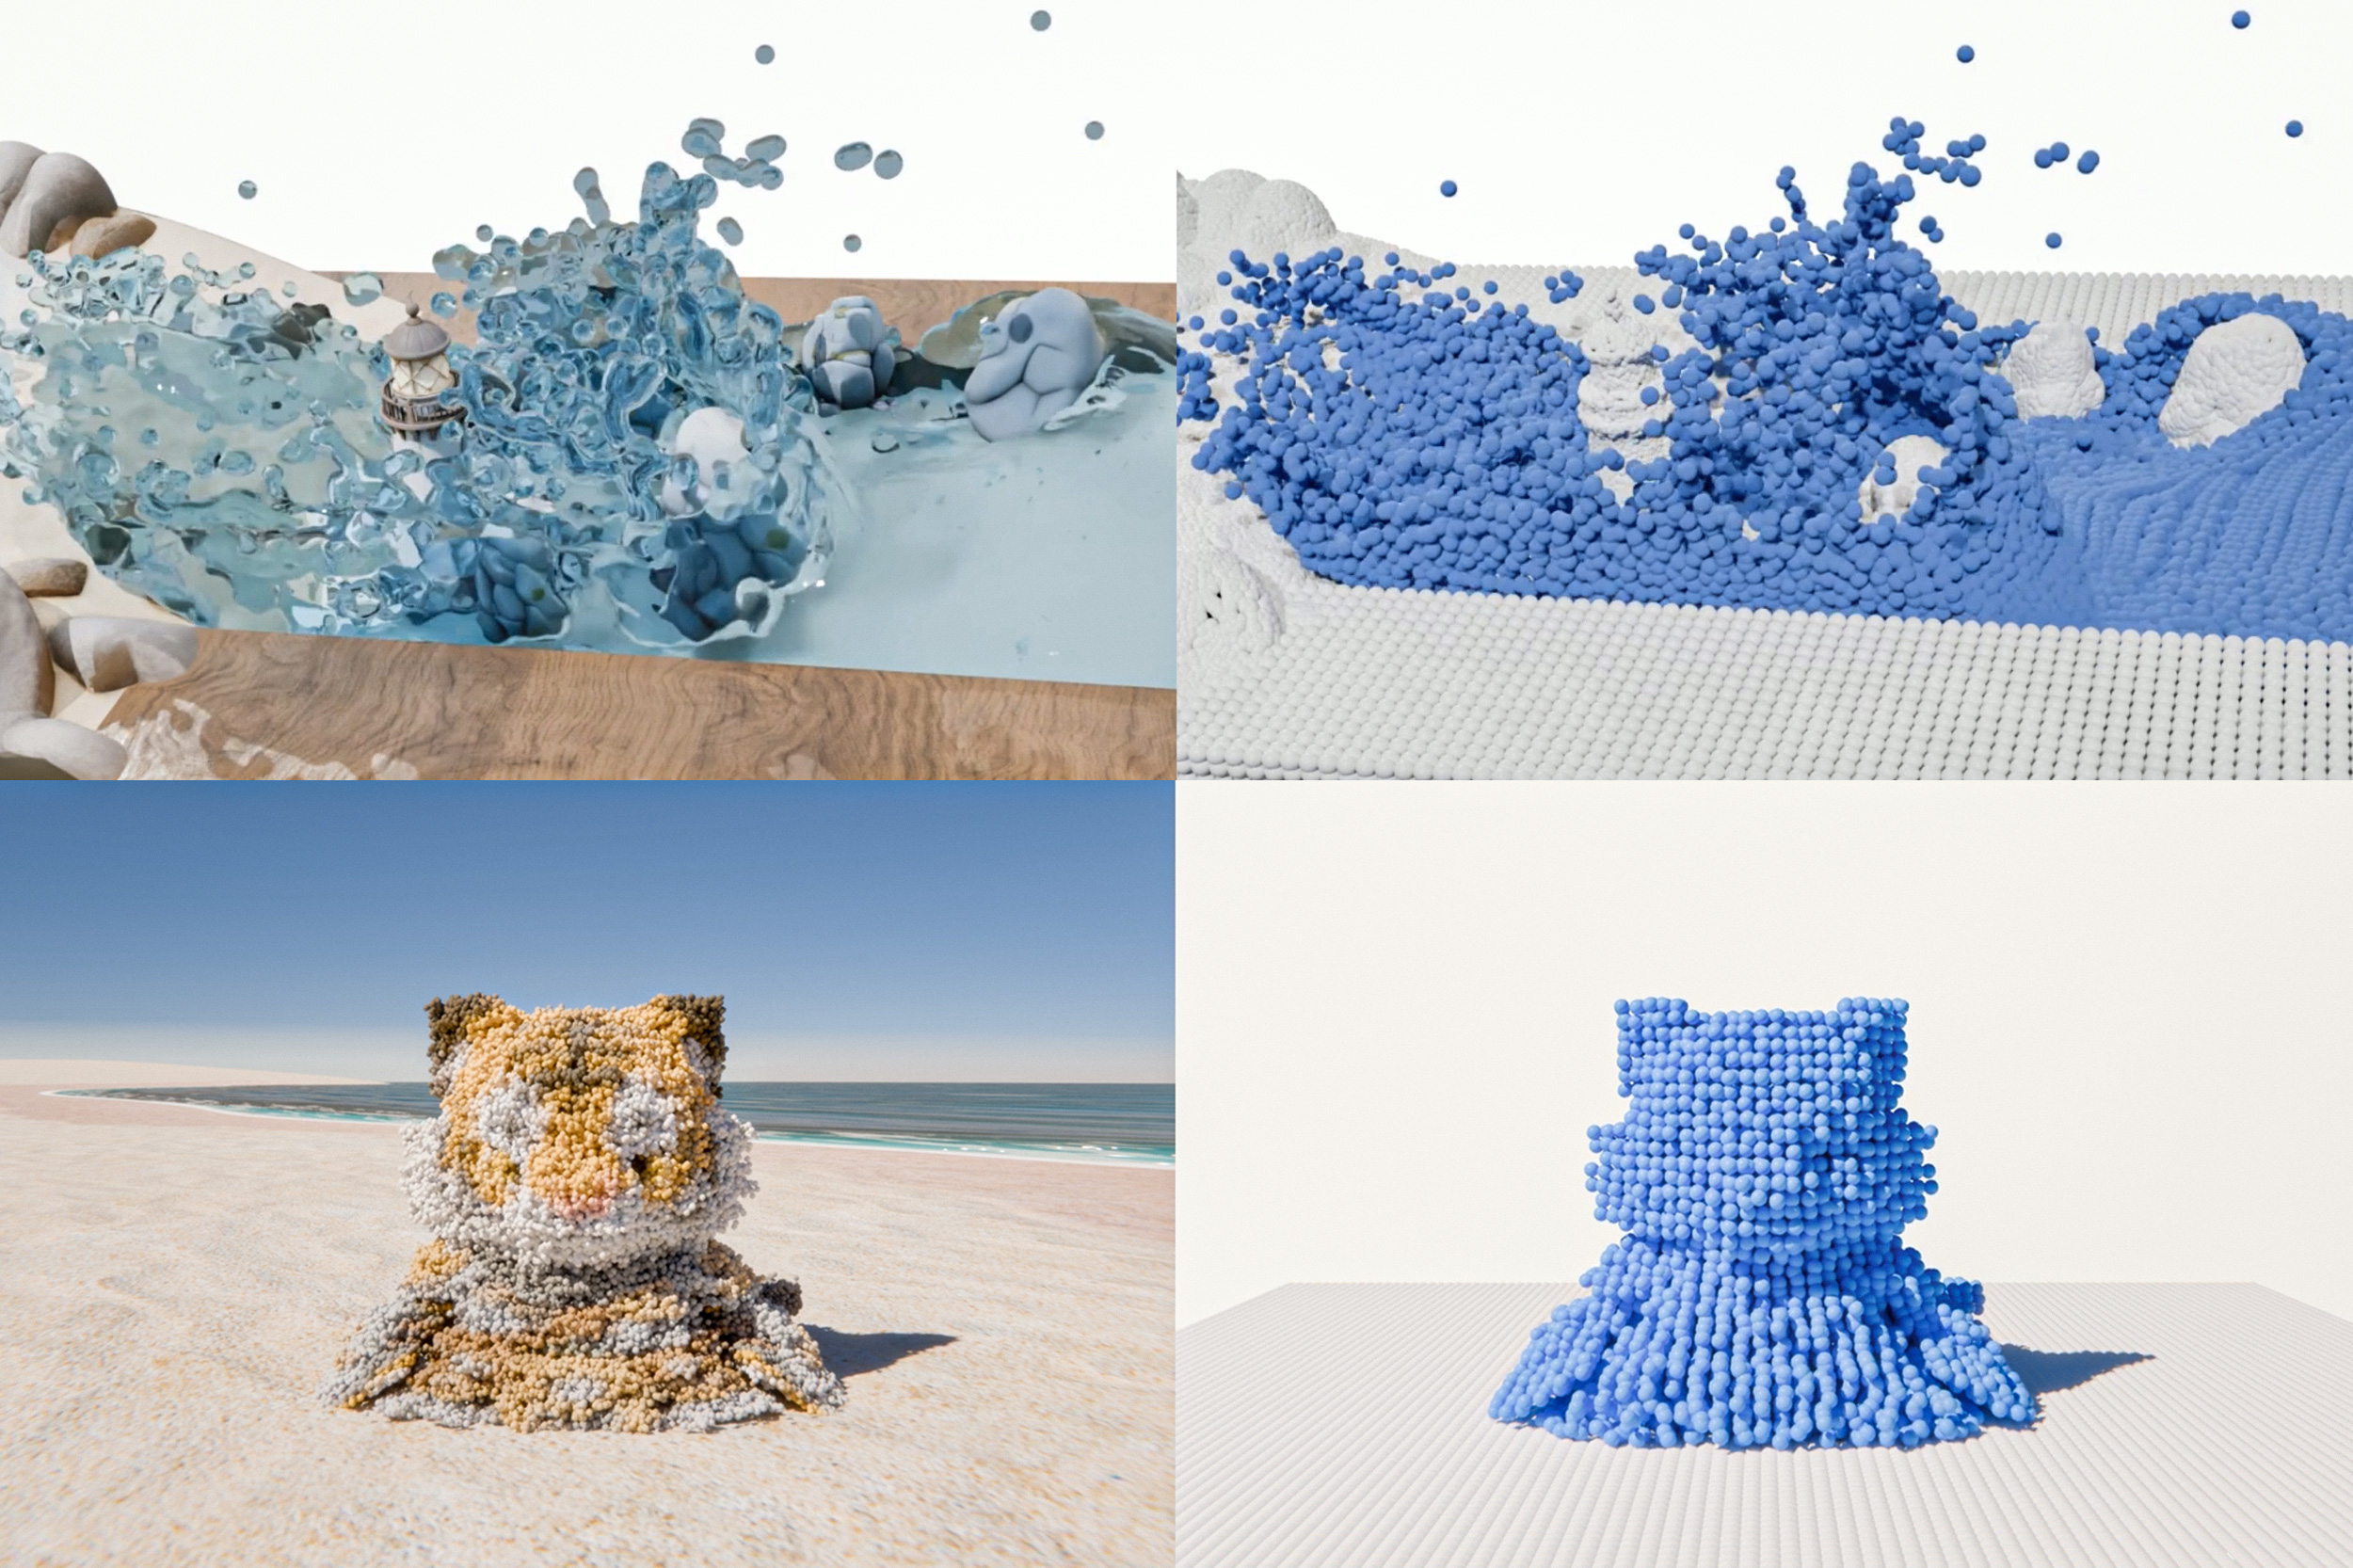
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Un sistema convierte artículos científicos en asistentes reutilizables
Un método empaqueta texto, código, datos y flujos de trabajo de algunos estudios para que una IA pueda ejecutar análisis y responder consultas en lenguaje natural.
Un cúbit lógico redujo sus errores a unos pocos por millón de ciclos
Un experimento con iones atrapados mostró que aumentar la protección de un cúbit lógico redujo de forma marcada sus errores. El resultado es prometedor, pero todavía es un preprint y una demostración de pequeña escala.
Más de la misma fuente
Ver mas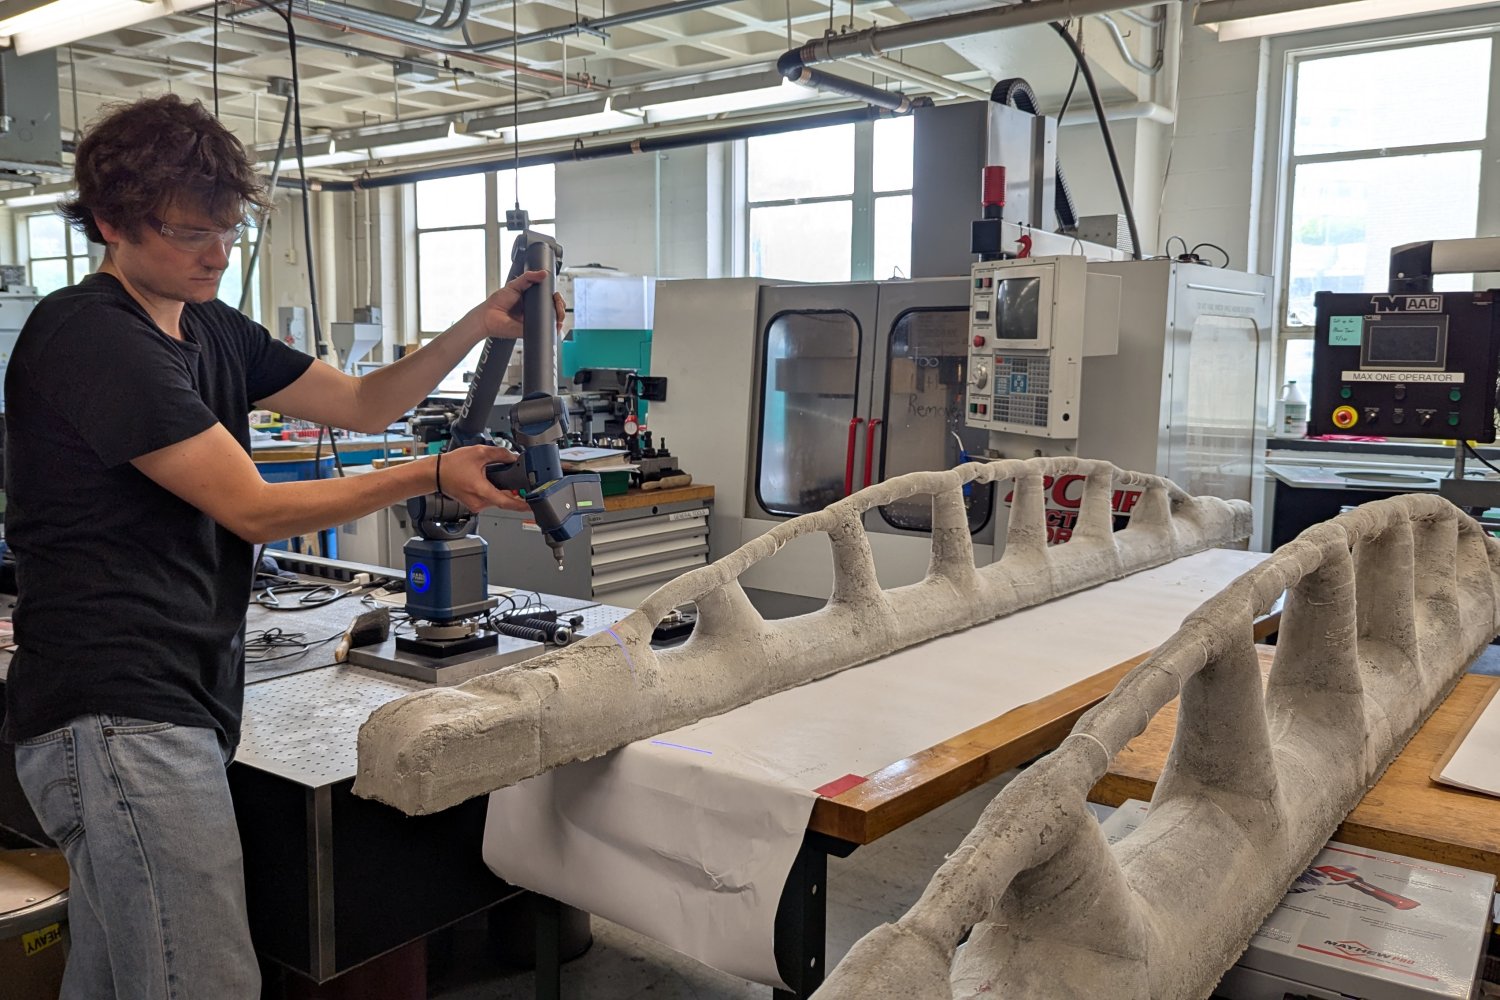
Una viga hecha con un molde textil usó mucho menos hormigón en una prueba real
Un equipo construyó y ensayó una viga de tres metros con un molde de tela: necesitó cerca de un tercio del hormigón y la mitad del acero de una viga convencional comparable.
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Los empujes raros de los quarks pesados podrían revelar el plasma primordial
Un cálculo teórico propone que los desvíos poco frecuentes de quarks pesados pueden aportar pistas sobre la estructura del plasma de quarks y gluones recreado en aceleradores.
Más del mismo autor
Ver mas
Cómo se instala Cryptosporidium en las células del intestino
Un estudio siguió paso a paso cómo Cryptosporidium se ancla a una célula intestinal y construye el límite desde el que obtiene recursos.
Partículas similares a virus mejoran la entrega de CRISPR en modelos de cerdo y pollo
Un estudio probó cápsulas microscópicas para llevar herramientas de edición genética a células, tejidos y embriones de cerdo y pollo. Aún no demuestra aplicaciones en animales vivos.
Un catalizador para modificar moléculas aromáticas en el punto preciso
Una nueva plataforma de paladio logra añadir grupos aromáticos a moléculas comunes y elegir con mayor precisión dónde ocurre la transformación.