

En teoría de juegos y en inteligencia artificial suele asumirse que, para problemas muy específicos, los mejores resultados deberían venir de algoritmos diseñados a medida. Un trabajo presentado en ICLR 2026 pone esa idea bajo sospecha. Investigadores vinculados al MIT muestran que, en ciertos juegos con información imperfecta, métodos más generales de aprendizaje por refuerzo pueden rendir mejor de lo esperado e incluso superar a algoritmos especializados en teoría de juegos.
La comparación se concentra en situaciones donde los jugadores no conocen todo lo que pasa, como ocurre en el póker, en negociaciones estratégicas o en muchos contextos reales donde cada parte actúa con información incompleta. En ese terreno, durante años se desarrollaron algoritmos muy específicos para aproximarse a estrategias óptimas. El nuevo trabajo reevalúa una familia más amplia y menos prestigiosa dentro de ese subcampo: los llamados métodos de gradiente de política, muy usados en aprendizaje por refuerzo.
La sorpresa del estudio es que esos métodos generalistas no solo compiten razonablemente bien, sino que en algunos escenarios logran mejores resultados frente a oponentes más entrenados. Dicho de forma simple, herramientas pensadas para aprender a actuar por experiencia pueden adaptarse mejor de lo que se creía a juegos estratégicos complejos, incluso cuando existen rivales concebidos específicamente para ese tipo de problemas.
Eso importa por dos razones. La primera es conceptual: recuerda que una solución elegante y especializada no siempre gana en la práctica frente a métodos más flexibles. La segunda es más amplia: si algoritmos relativamente generales funcionan bien en juegos con información imperfecta, podrían ser útiles en otros contextos donde la IA debe tomar decisiones sin ver el panorama completo, desde mercados y subastas hasta sistemas de negociación automatizada o planificación bajo incertidumbre.
El resultado también encaja con una tendencia mayor en inteligencia artificial. En varios campos, herramientas de propósito general vienen mostrando un alcance más amplio de lo previsto inicialmente. Este trabajo suma evidencia en esa dirección, pero dentro de un terreno donde la intuición dominante favorecía a los especialistas. No significa que los algoritmos diseñados para teoría de juegos hayan quedado obsoletos, sino que la frontera entre enfoques “generales” y “hechos a medida” puede ser más porosa de lo que parecía.
Como casi siempre en investigación computacional, conviene mantener la cautela. El estudio se refiere a ciertos tipos de juegos y a condiciones experimentales concretas, no a todos los problemas estratégicos posibles. Además, un mejor desempeño en benchmarks no garantiza por sí solo una ventaja inmediata en aplicaciones reales, donde importan también el costo computacional, la estabilidad y la robustez frente a entornos menos controlados. Aún así, el hallazgo deja una lección interesante: en algunos juegos complejos, el algoritmo más adaptable puede terminar ganándole al más especializado.
MIT News | Massachusetts Institute of Technology · Imagen acompañante del artículo fuente; atribución preservada · Fuente de imagen
Rudolph, M., Lichtlé, N., Mohammadpour, S., Bayen, A. M., Kolter, J. Z., Zhang, A., Farina, G., Vinitsky, E., & Sokota, S. (2026). Reevaluating policy gradient methods for imperfect-information games. In International Conference on Learning Representations (ICLR) 2026. OpenReview. https://doi.org/10.48550/arXiv.2502.08938
Relacionadas por categoría
Ver mas
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Un sistema convierte artículos científicos en asistentes reutilizables
Un método empaqueta texto, código, datos y flujos de trabajo de algunos estudios para que una IA pueda ejecutar análisis y responder consultas en lenguaje natural.
Un cúbit lógico redujo sus errores a unos pocos por millón de ciclos
Un experimento con iones atrapados mostró que aumentar la protección de un cúbit lógico redujo de forma marcada sus errores. El resultado es prometedor, pero todavía es un preprint y una demostración de pequeña escala.
Más de la misma fuente
Ver mas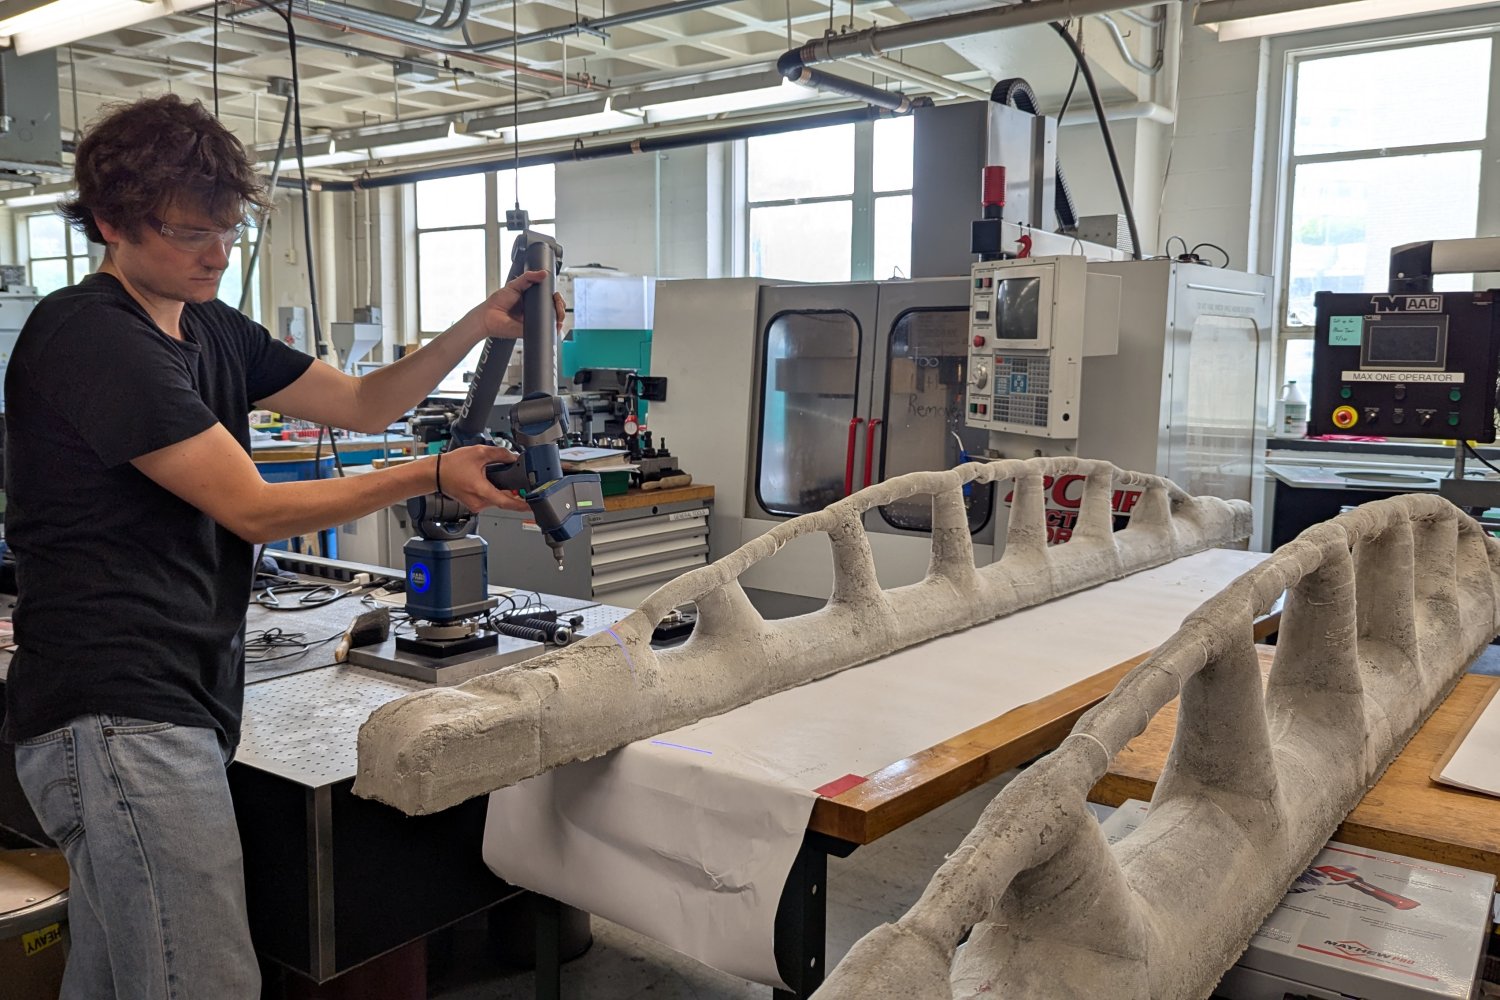
Una viga hecha con un molde textil usó mucho menos hormigón en una prueba real
Un equipo construyó y ensayó una viga de tres metros con un molde de tela: necesitó cerca de un tercio del hormigón y la mitad del acero de una viga convencional comparable.
Una IA intenta simular arena, agua y proteínas con un mismo modelo
Un preprint presenta WorldParticle, un modelo que representa distintos materiales como partículas para predecir su movimiento. Sus pruebas son prometedoras, pero no reemplazan todavía a los simuladores especializados.
Los empujes raros de los quarks pesados podrían revelar el plasma primordial
Un cálculo teórico propone que los desvíos poco frecuentes de quarks pesados pueden aportar pistas sobre la estructura del plasma de quarks y gluones recreado en aceleradores.
Más del mismo autor
Ver mas
Cómo se instala Cryptosporidium en las células del intestino
Un estudio siguió paso a paso cómo Cryptosporidium se ancla a una célula intestinal y construye el límite desde el que obtiene recursos.
Partículas similares a virus mejoran la entrega de CRISPR en modelos de cerdo y pollo
Un estudio probó cápsulas microscópicas para llevar herramientas de edición genética a células, tejidos y embriones de cerdo y pollo. Aún no demuestra aplicaciones en animales vivos.
Un catalizador para modificar moléculas aromáticas en el punto preciso
Una nueva plataforma de paladio logra añadir grupos aromáticos a moléculas comunes y elegir con mayor precisión dónde ocurre la transformación.